Domain docken.de kaufen?
Wir ziehen mit dem Projekt
docken.de um.
Sind Sie am Kauf der Domain
docken.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain docken.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **


Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Der HafenDer Hafen , Der Hafen ist die Lebensader Hamburgs, seit jeher prägt er den Charakter der Stadt als Handelsplatz und ihr Selbstverständnis als weltoffene Metropole. Die Bewohner Hamburgs hat er früh mit fremden Gebräuchen und exotischen Handelsgütern in Berührung gebracht, hat den Takt ihrer Arbeit bestimmt und ist stets ein Sehnsuchtsort für ein besseres Leben in der Ferne gewesen. Das Fotobuch Der Hafen zeigt diesen zentralen Schauplatz von Hamburgs Geschichte und Gegenwart aus einer besonderen Perspektive. Es lässt uns den Hafen mit den Augen von vier der bedeutendsten Hamburger Hafenfotografen des 20. Jahrhunderts sehen und geht damit über eine historische Bilddokumentation weit hinaus. Mit der jeweiligen Motivwahl und Bildsprache der Fotografen setzt jedes Kapitel einen eigenen thematischen und fotografischen Akzent. Den Auftakt macht Gustav Werbeck, der als Grafiker bei der HHLA tätig war und fast vierzig Jahre für das Unternehmen fotografierte. Seine Aufnahmen zeigen den Hafen der Vorkriegszeit und den Wiederaufbau nach dem Krieg. Die Bilder von John Holler und Germin (Gerd Mingram) rücken in eindrücklichen Porträts die Menschen und ihre Arbeit im Schiffbau in den Blick. Harald Zoch, der als Fahrer des HHLA-Vorstandsvorsitzenden im Hafen zu fotografieren begann, schließlich zeigt uns den Übergang vom Stückgutumschlag zum Einsatz des Containers, der tiefsten Zäsur in der Hafenentwicklung des 20. Jahrhunderts. , Einspritzdüsen > Einspritzanlagen & Teile , Auflage: 1. Auflage, Erscheinungsjahr: 201511, Fotograph: Werbeck, Gustav~Holler, John~Germin~Zoch, Harald, Redaktion: Rademacher, Henning, Auflage: 15001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 254, Fachschema: Hamburg / Bildband~Hamburg / Hafen, Schiffahrt, Warengruppe: HC/Bildbände/Deutschland, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 315, Breite: 255, Höhe: 30, Gewicht: 2087, Produktform: Gebunden, Genre: Reise,49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
Angebotsbeschreibungen für Online-Einkaufsportale zur automatischen Klassifizierung und Informationsextraktion mittels RekursiverAngebotsbeschreibungen Für Online-einkaufsportale Zur Automatischen Klassifizierung Und Informationsextraktion Mittels Rekursiver Transitionsnetzwerke, Taschenbuch Von Anja Klein, Grin, 978-3-668-14793-5, Seitenanzahl: 6427,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Der HafenDer Hafen , Der Hafen ist die Lebensader Hamburgs, seit jeher prägt er den Charakter der Stadt als Handelsplatz und ihr Selbstverständnis als weltoffene Metropole. Die Bewohner Hamburgs hat er früh mit fremden Gebräuchen und exotischen Handelsgütern in Berührung gebracht, hat den Takt ihrer Arbeit bestimmt und ist stets ein Sehnsuchtsort für ein besseres Leben in der Ferne gewesen. Das Fotobuch Der Hafen zeigt diesen zentralen Schauplatz von Hamburgs Geschichte und Gegenwart aus einer besonderen Perspektive. Es lässt uns den Hafen mit den Augen von vier der bedeutendsten Hamburger Hafenfotografen des 20. Jahrhunderts sehen und geht damit über eine historische Bilddokumentation weit hinaus. Mit der jeweiligen Motivwahl und Bildsprache der Fotografen setzt jedes Kapitel einen eigenen thematischen und fotografischen Akzent. Den Auftakt macht Gustav Werbeck, der als Grafiker bei der HHLA tätig war und fast vierzig Jahre für das Unternehmen fotografierte. Seine Aufnahmen zeigen den Hafen der Vorkriegszeit und den Wiederaufbau nach dem Krieg. Die Bilder von John Holler und Germin (Gerd Mingram) rücken in eindrücklichen Porträts die Menschen und ihre Arbeit im Schiffbau in den Blick. Harald Zoch, der als Fahrer des HHLA-Vorstandsvorsitzenden im Hafen zu fotografieren begann, schließlich zeigt uns den Übergang vom Stückgutumschlag zum Einsatz des Containers, der tiefsten Zäsur in der Hafenentwicklung des 20. Jahrhunderts. , Einspritzdüsen > Einspritzanlagen & Teile , Auflage: 1. Auflage, Erscheinungsjahr: 201511, Fotograph: Werbeck, Gustav~Holler, John~Germin~Zoch, Harald, Redaktion: Rademacher, Henning, Auflage: 15001, Auflage/Ausgabe: 1. Auflage, Seitenzahl/Blattzahl: 254, Fachschema: Hamburg / Bildband~Hamburg / Hafen, Schiffahrt, Warengruppe: HC/Bildbände/Deutschland, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 315, Breite: 255, Höhe: 30, Gewicht: 2087, Produktform: Gebunden, Genre: Reise,49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Angewandte Informationsextraktion und Sentimentanalyse, Taschenbuch von Ashraf Uddin,Rajesh Piryani,Vivek Kumar Singh, Verlag Unser Wissen,Angewandte Informationsextraktion Und Sentimentanalyse, Taschenbuch Von Ashraf Uddin,rajesh Piryani,vivek Kumar Singh, Verlag Unser Wissen, 978-620-9-62581-7, Seitenanzahl: 8043,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Bereichsspezifische Informationsextraktion für semantische Annotation, Taschenbuch von Zeeshan Ahmed, BoD - Books on Demand, 978-620-2-73428-8Bereichsspezifische Informationsextraktion Für Semantische Annotation, Taschenbuch Von Zeeshan Ahmed, Bod - Books On Demand, 978-620-2-73428-8, Seitenanzahl: 8426,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
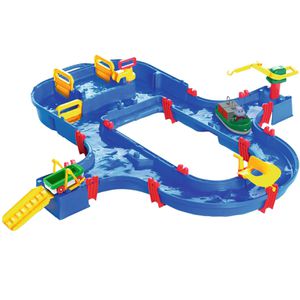
AquaPlay Wasserbahn 8700001520 Super-Set, mit Hafen,Schleuse und Anlegestelle, 29 TeileWasserspielwelt mit Schleuse und Handpumpe, einem Containerhafen mit Kran, Auffahrtsrampe, Spielfigur, Amphibienfahrzeug, Containerboot mit 2 Containern Aufbaumaß 115 x 105 cm, aus hochwertigem, UV-beständigem Kunststoff hergestellt Durch die Handkurbel können Kinder die Strömungsrichtung und Geschwindigkeit im Wasserkanal bestimmen Fördert die Motorik, Kreativität und das Verständnis für die physikalischen Prinzipien im Element Wasser Breite Wasserstraßen sorgen für langes Spielvergnügen Einfacher Aufbau, leicht kombinier- und erweiterbar mit weiteren AquaPlay-Sets Wasserdichte Verbindungen mittels selbstklebenden Gummidichtungen Ideal zum Spielen im Garten oder auf der Terrasse Altersempfehlung ab 3 Jahre Made in Germany Merkmale: Aufbaumaß: 115 x 105 cm Hinweis: Achtung! Nicht geeignet für Kinder unter 3 Jahren. Erstickungsgefahr durch Kleinteile.43,58 €*Versand: 4,15 €Sichere Weiterleitung zum Anbieter
-
Modell zur Informationsextraktion für Afan Oromo Nachrichtentexte, Taschenbuch von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7Modell Zur Informationsextraktion Für Afan Oromo Nachrichtentexte, Taschenbuch Von Sisay Abera, Verlag Unser Wissen, 978-620-5-59255-7, Seitenanzahl: 6849,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.